Qu'est-ce que l'OCR d'un PDF ?
Un scanner ou un téléphone enregistre une photo de la page. Le PDF obtenu ressemble à un document, mais il ne contient aucune lettre, seulement des pixels. La reconnaissance de caractères (OCR) repère les lettres dans l'image et en refait du texte, que l'on peut alors copier ou traduire.
Pour savoir si votre PDF en a besoin, essayez de sélectionner un mot. Si seul ce mot se surligne, le texte est déjà là. Si toute la page se sélectionne d'un bloc, ou rien du tout, c'est un scan.
Faire l'OCR d'un PDF gratuitement avec Google Drive
- Importez le PDF ou la photo dans Google Drive, sur un ordinateur.
- Faites un clic droit sur le fichier.
- Choisissez Ouvrir avec Google Docs.
- Formats
- PDF, même de plusieurs pages, et photos .jpeg, .png ou .gif[2].
- Taille
- 2 Mo au plus par fichier[2].
- Résolution
- Des caractères d'au moins 10 pixels de haut[2].
- Orientation
- La page doit être dans le bon sens ; faites-la pivoter avant l'import[2].
- Mise en forme
- Le gras, l'italique, la police et les sauts de ligne sont le plus souvent conservés. Les listes, les tableaux, les colonnes et les notes de bas de page ont peu de chances d'être détectés[2].
Un compte Google ordinaire suffit, chaque compte comprenant jusqu'à 15 Go de stockage pour Drive[1]. Pour un texte suivi dans sa langue d'origine, une lettre par exemple, c'est la solution la plus simple. LoreAI est fait pour traduire. Si vous voulez seulement le texte dans la langue du scan, Google Drive suffit.
Que manque-t-il à l'OCR pour convertir un PDF scanné en Word ?
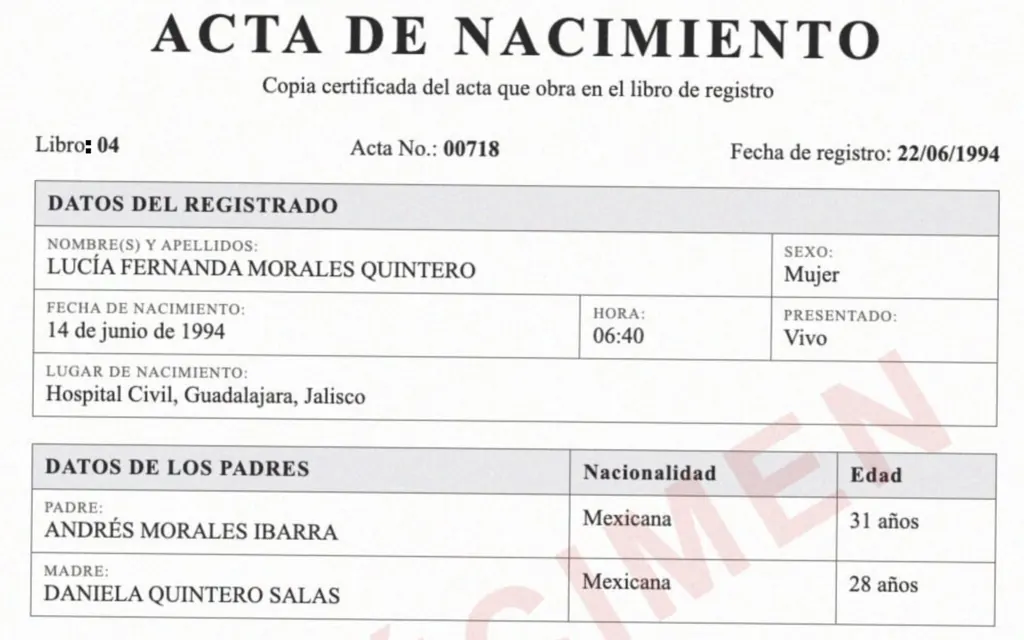
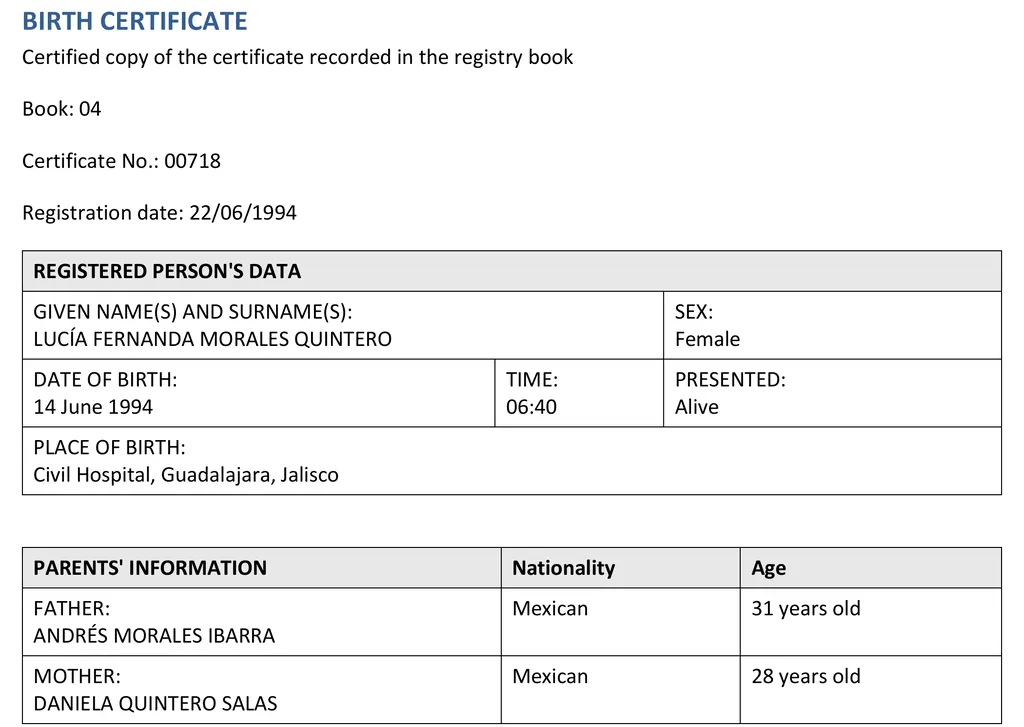
L'OCR rend des lettres, pas la structure de la page. Un acte de naissance, un relevé de notes ou une facture tiennent dans des tableaux, et Google prévient que ceux-ci ont peu de chances d'être détectés[2]. Vous obtenez alors un texte à plat, où les intitulés et les valeurs se suivent sans ordre clair.
LoreAI lit le scan, traduit le texte, puis reconstruit la page dans un fichier Word : titres, paragraphes, listes et tableaux, dans l'ordre de l'original. Les noms et les numéros restent tels qu'ils sont écrits, et vous décidez si les images de la page passent dans le fichier.
Traduction d'un PDF scanné en une seule étape
Les traducteurs de documents gratuits ne traitent pas tous les scans. L'aide anglaise de Google Traduction indique que le texte des pages scannées n'est pas traduit[3]. DeepL recommande ses applications bureau et mobile pour les documents numérisés, et prévient que la traduction de PDF, parce qu'elle repose sur l'OCR, peut avoir un taux d'erreur plus élevé[4].
- Créez un compte LoreAI gratuit. Le premier document est gratuit, jusqu'à 3 pages et 3 Mo.
- Importez le PDF scanné. Ou une photo de la page en JPG ou PNG.
- Choisissez la langue cible. La langue du scan est détectée, et 105 langues cibles sont proposées.
- Téléchargez le fichier Word. Relisez-le à côté du scan, en commençant par les noms et les chiffres.
Comment scanner pour une OCR fiable ?
- Posez la page bien à plat, sous une lumière égale, sans ombre ni reflet.
- Cadrez la page entière, droite, sans couper les bords.
- Gardez un texte assez grand. Pour son OCR, Google Drive demande des caractères d'au moins 10 pixels de haut[2].
- Préférez un fond clair et un bon contraste ; Google conseille des images nettes à la luminosité homogène[2].
Ce que l'OCR lit mal
Les tampons, les signatures et l'écriture manuscrite sont ce que la reconnaissance de caractères lit le moins bien. Sur un document tapé, les erreurs viennent souvent de caractères proches : le O et le zéro, le l minuscule et le 1, une lettre accentuée prise pour une autre. Relisez en priorité les noms, les dates, les numéros de dossier et les montants.
Que deviennent vos fichiers ?
LoreAI supprime le fichier envoyé juste après l'avoir lu, sur son propre serveur et chez son prestataire de reconnaissance de caractères. Le texte extrait, la traduction et le fichier Word sont effacés automatiquement environ une heure plus tard, sauf si vous activez Keep my translated documents dans les réglages. Les détails figurent dans la politique de confidentialité (en anglais).
Les autres guides en français
- Traduire un PDF en français
- Traduire un document de l'anglais vers le français
- Google Traduction et les PDF scannés
- Traduire une image
Tous les guides en français sont réunis sur la page Documents. Pour envoyer un document tout de suite, passez par la page d'accueil.
Questions fréquentes
Comment faire l'OCR d'un PDF gratuitement ?
Comment convertir un PDF scanné en Word ?
Google Drive le convertit en document Google Docs, sans garantie pour les tableaux[2]. Pour un scan avec des tableaux, ou un scan à traduire, LoreAI rend directement un fichier Word traduit.
L'OCR reconnaît-elle l'écriture manuscrite ?
Mal, en général. Google Drive conseille des polices courantes comme Arial ou Times New Roman[2], et une écriture à la main s'en éloigne. Relisez chaque mot écrit à la main.
Mon PDF scanné est trop lourd pour Google Drive. Que faire ?
Découpez-le ou réduisez sa résolution, en gardant des caractères d'au moins 10 pixels de haut[2]. LoreAI accepte 3 Mo pour le document gratuit, 10 Mo avec Basic et 25 Mo avec Pro.
Sources
- Aide Google One : Fonctionnement de votre espace de stockage Google, consulté le 2 novembre 2026
- Aide Google Drive : Convertir des fichiers PDF et des photos en fichier texte, consulté le 2 novembre 2026
- Google Translate Help, version anglaise de la même page, avec la mention des pages scannées, consulté le 2 novembre 2026
- DeepL : Traduisez vos documents PDF, consulté le 2 novembre 2026
Par Matt Mountain ·