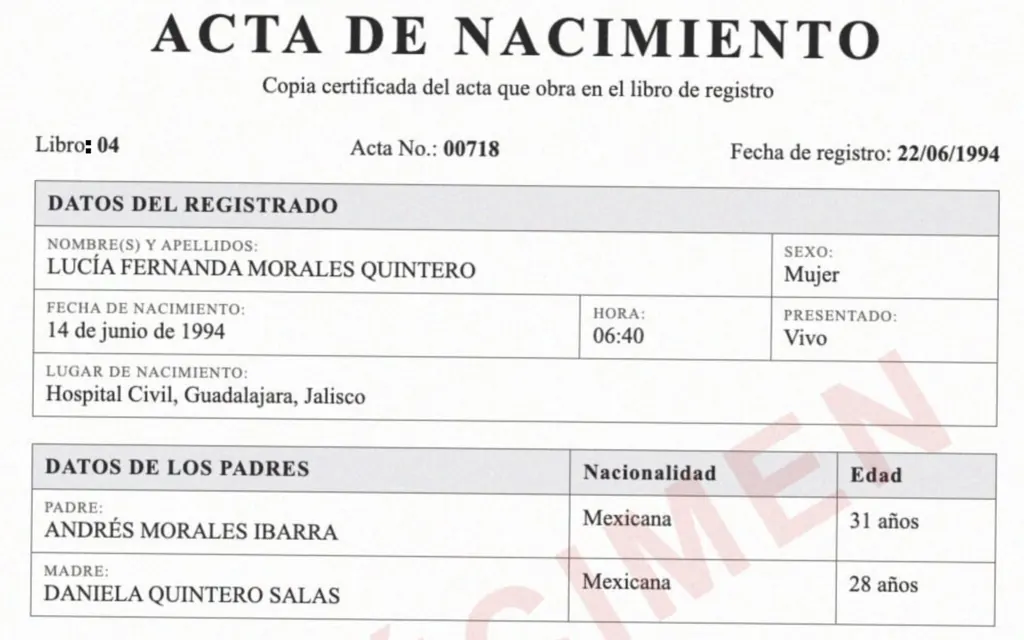
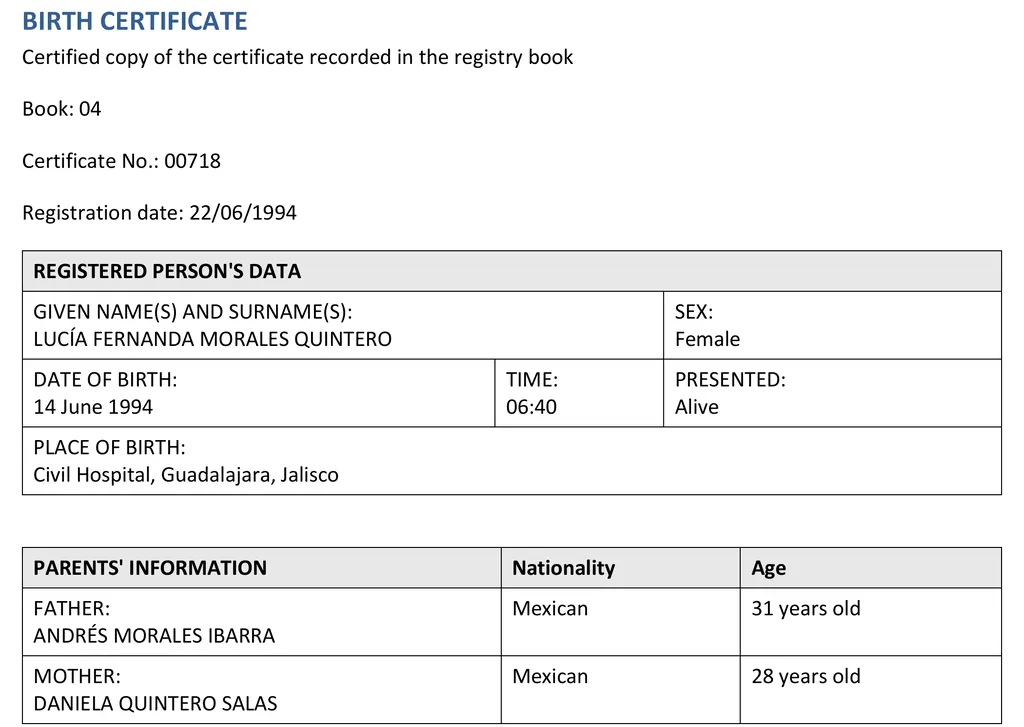
Warum ein Scan anders ist als ein normales PDF
Ein Scanner oder eine Handykamera speichert jede Seite als Foto. Das PDF sieht aus wie ein Dokument, enthält aber keine Buchstaben, nur Bildpunkte. Ein Übersetzungsprogramm, das nur die Textebene liest, findet darin nichts, was es übersetzen kann.
Prüfen Sie Ihre Datei, bevor Sie sie hochladen. Öffnen Sie das PDF und ziehen Sie die Maus über einen Satz. Lässt sich der Satz markieren und kopieren, hat das PDF Text. Markiert sich nur ein Rechteck oder gar nichts, ist es ein Scan. Viele Dateien sind gemischt, etwa ein getippter Vertrag mit einer gescannten Unterschriftenseite.
Warum übersetzen Google und DeepL ein gescanntes PDF unterschiedlich?
Google schreibt in seiner Hilfe, dass Text in Bildern und gescannten PDF-Seiten zwar im übersetzten Dokument erscheint, aber nicht übersetzt wird[1]. Wer ein gescanntes Dokument dort hochlädt, bekommt also die Seite in der Originalsprache zurück.
DeepL gibt an, Text aus gescannten PDFs sowie aus PNG- und JPG-Bildern mit optischer Zeichenerkennung zu lesen und dabei das Layout zu behalten[2]. Auf seiner PDF-Seite empfiehlt DeepL für gescannte Dokumente die Desktop- und Handy-Apps und weist darauf hin, dass PDF-Übersetzungen auf Zeichenerkennung beruhen und deshalb mehr Fehler haben können[3].
Wie funktioniert OCR plus Übersetzung?
Die Texterkennung sucht auf dem Bild nach Zeichen, setzt sie zu Wörtern und Zeilen zusammen und bestimmt die Reihenfolge der Blöcke. Bei einem Formular ordnet sie außerdem jede Angabe dem richtigen Feld zu. Erst dieser erkannte Text wird übersetzt.
Fehler der Texterkennung wandern in die Übersetzung weiter. Typisch sind eine 0, die als O gelesen wird, eine 1 als kleines l oder ein Stempel, der über einer Zeile liegt. Deshalb lohnt sich der Vergleich von Namen, Daten und Nummern mit dem Original. LoreAI übernimmt sie so, wie sie auf dem Scan stehen, und baut Überschriften, Listen und Tabellen in der Word-Datei nach.
So übersetzen Sie ein gescanntes PDF mit LoreAI
- Kostenloses Konto anlegen. Das erste Dokument kostet nichts, bis 3 Seiten und 3 MB.
- Den Scan hochladen. PDF, JPG und PNG funktionieren. Eine Textebene braucht die Datei nicht.
- Zielsprache auswählen. Es gibt 105 Zielsprachen. Die Sprache des Scans erkennt LoreAI selbst.
- Word-Datei herunterladen. Legen Sie Original und Übersetzung nebeneinander und korrigieren Sie, was die Texterkennung falsch gelesen hat.
Wie scanne ich richtig?
Ein guter Scan spart Ihnen die meiste Nacharbeit. Googles Hilfe zur Texterkennung in Drive nennt dafür einige Regeln[4].
- Der Text sollte mindestens 10 Pixel hoch sein[4]. Scannen Sie lieber in höherer Auflösung als zu klein.
- Die Seite muss richtig herum liegen. Drehen Sie schiefe oder auf dem Kopf stehende Scans vor dem Hochladen[4].
- Achten Sie auf ein scharfes Bild, gleichmäßiges Licht und klaren Kontrast[4]. Ein Schatten über einer Zeile kostet oft ganze Wörter.
- Legen Sie die Seite flach und scannen Sie sie vollständig, mit Rand, Stempeln und Rückseite.
Fotografieren Sie ein Dokument mit dem Handy, finden Sie Tipps dafür im Ratgeber Bild übersetzen. Warum der Google Übersetzer bei Scans nicht weiterhilft, zeigt der Ratgeber zum Google Übersetzer.
Häufige Fragen
Warum ist mein übersetztes PDF noch in der Originalsprache?
Weil das PDF ein Scan ist. Der Google Übersetzer übersetzt Text in gescannten Seiten nicht und gibt die Seite unverändert zurück[1]. Sie brauchen ein Werkzeug, das vorher eine Texterkennung macht.
Kann DeepL gescannte PDFs übersetzen?
Geht das auch ohne Scanner?
Ja. Fotografieren Sie die Seite mit dem Handy und laden Sie das Foto als JPG oder PNG hoch. Die Texterkennung arbeitet damit genauso wie mit einem gescannten PDF.
Was passiert mit meinem Scan?
LoreAI löscht die hochgeladene Datei direkt nach dem Auslesen. Die Ergebnisse werden etwa eine Stunde später entfernt, außer Sie schalten Keep my translated documents ein.
Quellen
- Google Translate Help, englische Fassung, mit dem Hinweis zu gescannten PDF-Seiten, abgerufen am 2. November 2026
- DeepL: Dokumentübersetzung, Häufig gestellte Fragen, abgerufen am 2. November 2026
- DeepL: PDF-Dateien übersetzen, abgerufen am 2. November 2026
- Google Drive-Hilfe: PDF-Dateien und Bilder in Text umwandeln, abgerufen am 2. November 2026
Von Matt Mountain ·